让识别结果成为整理工作的起点
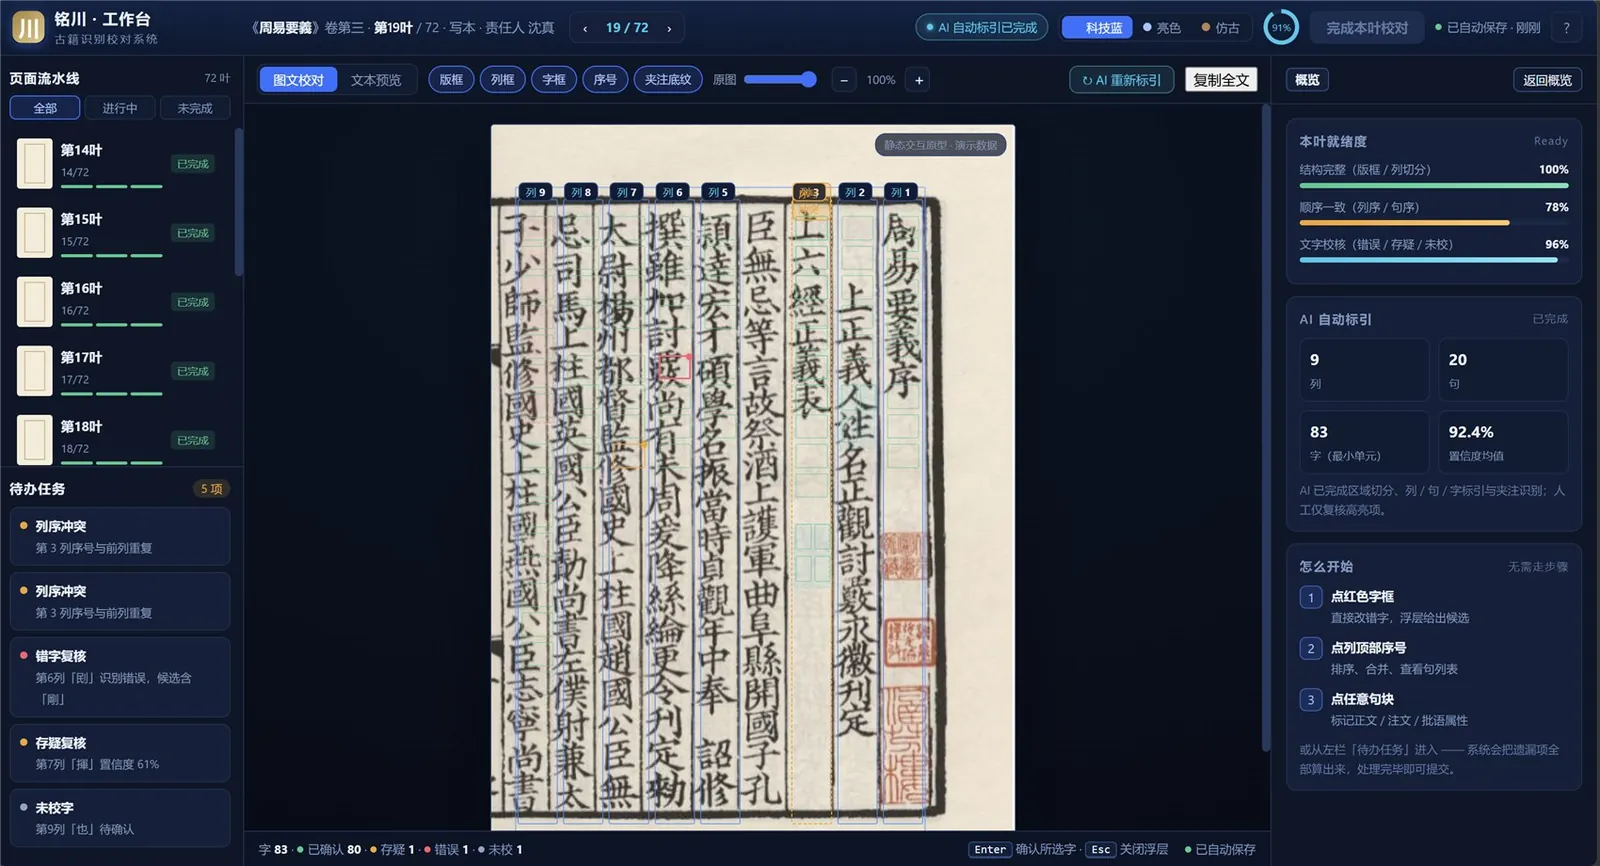
古籍页面的阅读顺序和文本结构不同于普通现代文档。只把 OCR 文本放在页面旁边,仍然需要整理者逐行寻找位置、逐字对照,机器识别并没有真正融入工作过程。
我设计这套工作台时,将页面、识别文本与结构标引放在一起。系统先识别并拆分内容;整理者可以在原文和识别结果之间对应查看,集中处理需要判断的文字和标注。
人机协作的边界
- 按列、句、字组织识别与校对结构,方便在不同粒度间切换。
- 保留疑点和校勘过程,让修改有上下文,也可以回看。
- 让 AI 负责初步识别与整理,人对关键字词、标引和校勘结果负责。
这里的 AI 不是替代整理者,而是把机械性工作提前做完,让专业判断更集中地发生。